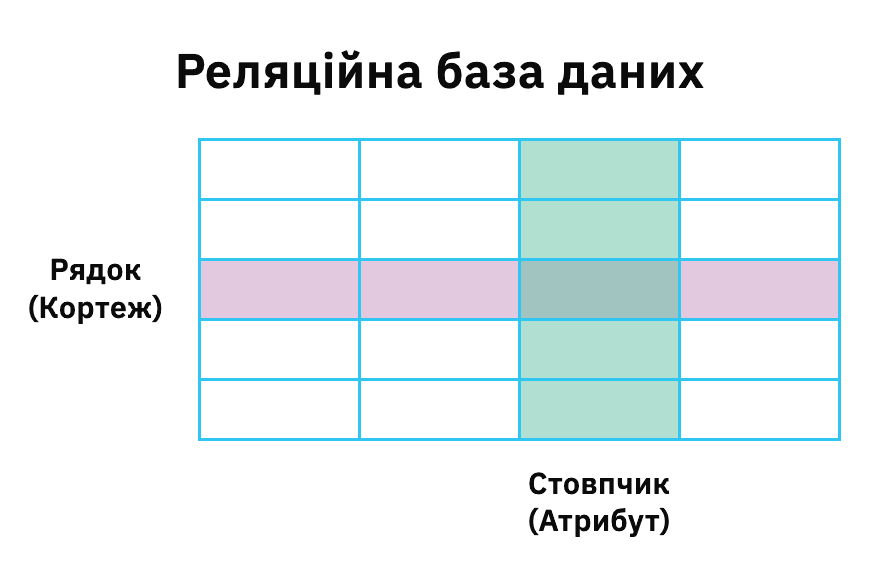
В реляционной базе данных таблицы выполняют роль фундаментальной структуры, превращающей хаотический поток фактов в упорядоченную, взаимосвязанную систему. Каждая таблица хранит данные о конкретной сущности — пользователях, заказах, товарах или пациентах — в виде строк и столбцов, где каждая ячейка содержит атомарное значение. Такая организация позволяет не только сохранять информацию, но и поддерживать ее целостность, быстро находить нужные фрагменты и совмещать их в сложные запросы без предварительно определенных связей.
Эдгар Кодд в 1970 году предложил именно эту модель для достижения data independence — независимости логической структуры данных от физического способа их хранения. До этого базы данных строились на иерархических или сетевых принципах: связи жестко прописывались в коде приложений, а любое изменение структуры требовало переписки программ. Таблицы же позволили описывать данные декларативно: приложение «видит» только логические отношения, а система управления базой данных сама решает, как оптимально разместить данные на диске или в памяти.
Математическая природа таблиц и их назначение
В теории реляционная таблица – это отношение (relation): набор кортежей, где каждый кортеж состоит из значений атрибутов, взятых из определенных доменов. Порядок строк и столбцов логически не имеет значения, а дубликаты строк запрещены – это чистое математическое множество. Вот почему таблицы обеспечивают предсказуемость результатов запросов и разрешают использовать операции реляционной алгебры: выборку, проекцию, соединение, объединение.
На практике это означает, что разработчик может добавить новый столбец или изменить тип данных в таблице, не ломая уже написанные запросы, не использующие этот столбец. Физические изменения – перемещение файлов, создание индексов, партиционирование – происходят «под капотом» и не влияют на логику приложения. Такая гибкость стала основой для развития современных веб-сервисов, аналитических платформ и корпоративных систем, где данные постоянно обновляются и анализируются с разных ракурсов.
Структура таблицы: строки, столбцы и ограничение целостности
Каждая таблица имеет уникальное имя внутри схемы базы данных. Столбцы определяют атрибуты сущности и их типы данных — целые числа, строки, даты, булевые значения или более сложные типы типа JSON в современных СУБД. Строки представляют конкретные экземпляры: одна строка – один клиент, один заказ, одна запись о визите к врачу.
Чтобы таблица выполняла свое предназначение, на столбце накладываются ограничения. Первичный ключ гарантирует уникальность каждой строки и запрещает значение NULL. Внешние ключи создают связи с другими таблицами и обеспечивают ссылочную целостность: нельзя удалить клиента, пока есть его заказы, если на внешнем ключе стоит ограничение ON DELETE RESTRICT. Дополнительные CHECK-ограничения и NOT NULL защищают от некорректных данных еще на уровне базы, прежде чем они попадут в бизнес-логику.
Первичные и внешние ключи: оживляющие мостики
Без ключей таблицы оставались бы изолированными «плоскими» списками. Первичный ключ – это минимальный набор столбцов, однозначно идентифицирующий строку. Чаще всего это суррогатный автоинкрементный идентификатор, потому что натуральные ключи (электронная почта, номер паспорта) могут изменяться или содержать дубликаты в реальной жизни.
Внешний ключ таблицы «Заказ» ссылается на первичный ключ таблицы «Клиенты». Когда выполняется JOIN, система совмещает строки по совпадению значений этих ключей. Таким образом, рождаются сложные отчеты: «все заказы клиента из Киева за последний квартал с суммой более 5000 грн». Без внешних ключей и ограничений целостности такие запросы становились бы источником ошибок – «призраков» данных, ссылающихся на несуществующие записи.
Нормализация: как таблицы лишаются излишеств и аномалий
Нормализация – это процесс приведения таблиц к нормальным формам, чтобы устранить вредную избыточность и зависимости. В первой нормальной форме (1NF) все значения в ячейках атомарны, нет повторяющихся групп. Вторая форма (2NF) требует, чтобы неключевые атрибуты зависели от первичного ключа, а не от его части. Третья форма (3NF) устраняет транзитивные зависимости: атрибут не должен зависеть от другого неключевого атрибута.
Представим плоскую таблицу "Заказ", где в каждой строке дублируются имя клиента, его адрес и телефон. Если клиент сменит телефон, придется обновлять десятки строк — иначе появится аномалия обновления. Если удалить последний заказ клиента, можно потерять информацию о нем самом – аномалия удаления. Нормализация разбивает такую таблицу на «Клиенты» и «Заказ», где имя и телефон хранятся только в одной таблице, а заказы ссылаются на нее через внешний ключ. Результат – данные занимают меньше места, обновления становятся атомарными, а целостность поддерживается автоматически.
| Эта проблема | Пример к нормализации | Следствие |
|---|---|---|
| Избыточность | Имя клиента повторяется по каждому заказу | Лишнее место на диске, риск разногласий |
| Аномалия обновления | Смена телефона требует редактирования 50 строк | Часть данных остается устаревшей |
| Аномалия удаления | Удаление последнего заказа стирает данные клиента | Утрата важной информации |
Более высокие нормальные формы (BCNF, 4NF, 5NF) решают еще более сложные зависимости, но на практике большинство систем останавливаются на 3NF или BCNF — компромисс между чистотой модели и производительностью запросов.
| Типичные ошибки при проектировании таблиц Отсутствие или слабый первичный ключ. Использование натуральных ключей, которые могут быть изменены (электронная почта, номер телефона), приводит к каскадным обновлениям по всей базе и нарушению ссылочной целостности. Лучше добавить суррогатный ID и наложить на него PRIMARY KEY. Хранение чрезмерных данных в одной таблице. Дублирование имени клиента, его адреса и истории покупок в таблице заказов. Любое изменение требует массовых обновлений и создает риск несогласованности. Нормализация с отдельными таблицами и внешними ключами устраняет проблему. Игнорирование ограничений целостности. Отсутствие FOREIGN KEY, CHECK или NOT NULL позволяет приложению записывать некорректные данные — заказы без клиента, отрицательные цены, пустые обязательные поля. База данных должна защищать себя сама, а не полагаться только на код приложения. Чрезмерная нормализация без учета нагрузки. Доведение модели до 5NF в системе с интенсивным чтением может привести к десяткам JOIN в каждом запросе. В таких случаях обоснованная денормализация (сложение кэшированных полей или materialized views) повышает скорость без потери контроля над записью. Плохие типы данных и отсутствие индексов. Хранение дат VARCHAR, использование TEXT для всех текстовых полей или отсутствие индексов на столбцах, по которым часто фильтруют и сортируют. Это приводит к медленным запросам и чрезмерному потреблению ресурсов даже на небольших объемах данных. Каждая из этих ошибок на этапе проектирования оборачивается техническим долгом, который дорого исправляется через месяцы или годы эксплуатации системы. |
Практическая работа таблиц в реальных системах
В банковской сфере таблицы "Счета", "Транзакции" и "Клиенты" вместе с механизмами транзакций (ACID) гарантируют, что перевод средств состоится полностью или не состоится вообще. Дебет одного счета и кредит другого фиксируются в одной атомарной операции — если что-то пойдет не так, база откатит изменения, и деньги не исчезнут.
В электронной коммерции таблица «Товары» хранит актуальные цены и остатки, «Заказ» – состав заказа через промежуточную таблицу «Позиции_заказа», а «Клиенты» – персональные данные. JOIN этих таблиц дает полную картину для аналитики: какие товары чаще покупают вместе, какой сегмент клиентов приносит наибольший доход, как сезонность влияет на продажи. Без четкой структуры таблиц такие отчеты приходилось собирать вручную из разрозненных файлов.
В медицинских информационных системах таблицы Пациенты, Визиты, Диагнозы и Лекарства с правильно настроенными внешними ключами и row-level security позволяют врачу видеть только данные своих пациентов, а системе автоматически проверять совместимость лекарств. Изменение структуры (сложение нового типа обследования) не требует переписки всех отчетов — достаточно добавить новую таблицу или столбец и обновить соответствующие запросы.
Современный контекст: таблицы остаются основой даже в облаке
Облачные СУБД – PostgreSQL на AWS RDS, Cloud SQL от Google, Azure SQL – продолжают использовать реляционные таблицы как базовую абстракцию. Добавляются новые возможности: автоматическое шардирование, columnar storage для аналитики, встроенные векторные индексы для AI-запросов, но логическая модель остается прежней – таблицы, строки, ключи, JOIN-ы. Даже многие NoSQL-системы сейчас предлагают SQL-подобные интерфейсы или поддержку ACID-транзакций поверх документных или графовых моделей, признавая силу реляционного подхода для большинства бизнес-сценариев.
Когда объемы данных достигают петабайтов, таблицы партиционируют по времени, региону или хэшу, создают materialized views для ускорения частых запросов, применяют индексы разных типов (B-tree, GiST, BRIN). Однако для разработчика и аналитика все равно остается привычная картина: SELECT… FROM table1 JOIN table2… . Именно поэтому понимание назначения таблиц, их структуры и принципов проектирования остается ключевым навыком для любого специалиста, работающего с данными – от начинающего, создающего первую базу для блога, до архитектора enterprise-системы.
Каждая правильно спроектированная таблица – это не просто контейнер для цифр и строк. Это контракт между данными и использующими их: разработчиками, аналитиками, бизнесом. Соблюдение этого контракта через первичные и внешние ключи, нормальные формы и ограничения целостности превращает базу данных в надежный источник правды, а не в источник постоянных сомнений и ручной чистки информации.